Der agentische Stack 2026, Teil 2: 20 weitere Werkzeuge für Gedächtnis, Qualität und Ausführung
Kurz erklärt
Pinecone, Weaviate, Zep, LiteLLM, Braintrust, Composio und 14 weitere: die Schichten, die man erst braucht, wenn ein Prototyp in Betrieb geht — mit Grenzen, Quellen und vier Auswahlfragen.
Inhaltsverzeichnis
Der erste Teil dieser Reihe hat zwanzig Werkzeuge beschrieben, die einen agentischen Stack tragen: Datenbank, Auslieferung, Laufzeit, Beobachtbarkeit, Geschäftsprozesse. Danach kam dieselbe Frage mehrfach zurück: Und was fehlt noch?
Es fehlt vor allem das, was man erst merkt, wenn ein Prototyp in Betrieb geht. Wo liegt das Gedächtnis eines Agenten, wenn das Kontextfenster nicht reicht? Wie bekommt man Modellkosten je Anwendungsfall auf eine Rechnung? Wo läuft Code, den ein Agent selbst geschrieben hat? Wer sagt, ob eine Änderung die Qualität verbessert hat – und nicht nur anders klingt?
Die folgenden zwanzig Werkzeuge beantworten genau diese Fragen. Sortiert nach Kategorie, jedes mit eigenem Glossareintrag. Preise nennen wir nicht: Sie ändern sich schneller als dieser Artikel, und die Modelle sind bei fast allen Anbietern nutzungsabhängig.
Ein Hinweis vorab, der wichtiger ist als jede Werkzeugwahl: Bei keinem der hier genannten Dienste sollte man Datenhaltung in der EU oder Auftragsverarbeitung voraussetzen. Belegbar selbst betreibbar sind Weaviate, Qdrant, Helicone, Arize Phoenix und Trigger.dev. Bei allen übrigen gehört das vertraglich geklärt, nicht angenommen.
Inhalt
- Daten und Gedächtnis: Pinecone, Weaviate, Zep, LlamaIndex
- Modellzugang und Agenten-Frameworks: LiteLLM, Pydantic AI, Microsoft Agent Framework
- Infrastruktur und Ausführung: Modal, Daytona, Trigger.dev
- Web-Daten und Werkzeugzugriff: Apify, Scrapfly, Composio
- Qualität und Beobachtbarkeit: Braintrust, Helicone, Arize Phoenix
- Identität, Sprache und Zahlung: Clerk, ElevenLabs, Vapi, Stripe Agentic Commerce
1) Daten und Gedächtnis
Ein Agent ist nur so gut wie das, was er findet – und was er vom letzten Gespräch behalten hat.
Pinecone
Verwaltete Vektordatenbank für semantische Suche und RAG. Indizes, Namespaces zur Mandantentrennung, Metadatenfilter vor der Suche – ohne eigenen Betrieb. Sinnvoll ab dem Punkt, an dem pgvector in der Anwendungsdatenbank spürbar langsamer wird; darunter ist eine zweite Datenbank vor allem Aufwand.
Weaviate
Quelloffene Vektordatenbank mit hybrider Suche: Schlagwort und Bedeutung in einer Abfrage, gewichtet. Genau das rettet Produktcodes und Markennamen, die rein semantische Suche regelmäßig verliert. Und weil Self-Hosting belegbar möglich ist, bleibt sie in DSGVO-Diskussionen eine echte Option.
Zep
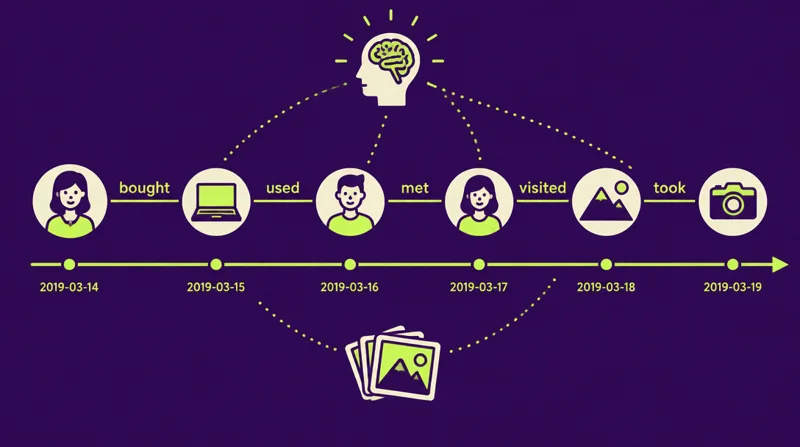
Gedächtnisschicht, die aus Gesprächen einen zeitlichen Wissensgraphen baut – Fakten als Beziehungen mit Gültigkeitszeitraum. Veraltete Aussagen verschwinden nicht, sie werden ungültig. Der quelloffene Kern heißt Graphiti. Vorsicht: Diese Schicht ist bewusst ein Personenprofil und braucht Zweckbindung, Frist und Löschweg.
LlamaIndex
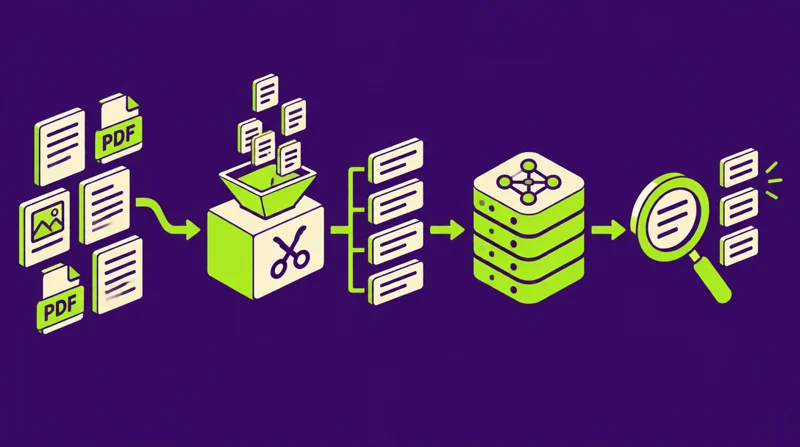
Framework für den unspektakulären Teil von RAG: einlesen, zerlegen, indexieren, abrufen, zitieren. Die meisten schlechten Antworten stammen aus der Aufbereitung, nicht vom Modell – zu große Abschnitte, verlorene Tabellen, fehlende Metadaten, kein Reranking. Genau da setzt es an.
2) Modellzugang und Agenten-Frameworks
Die Schicht, in der aus Modellaufrufen eine Kostenstelle und aus einer Schleife ein wartbarer Ablauf wird.
LiteLLM
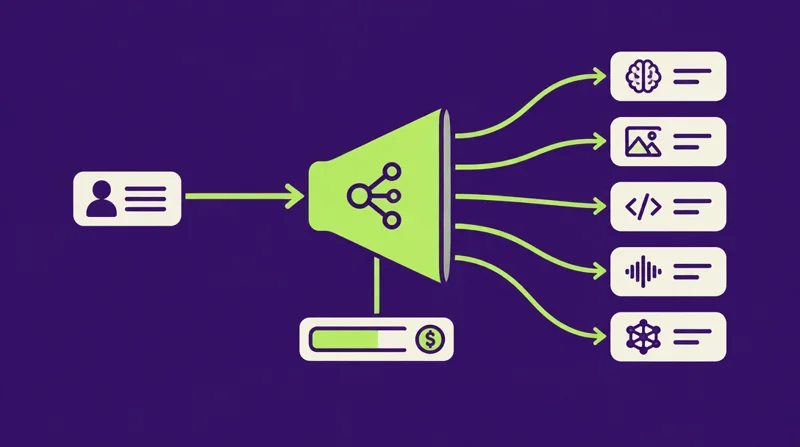
Über 100 Modelle im OpenAI-Format, als Bibliothek oder als eigener Gateway. Der Gateway ist der eigentliche Grund: virtuelle Schlüssel je Team, Budgets, Ausweichrouten bei Ausfall und – das Entscheidende für Entscheider – Kosten je Anwendungsfall auf einem Bericht. Er ist damit auch ein zentraler Engpass und braucht Redundanz.
Pydantic AI
Python-Agenten-Framework mit typisierten Ausgaben: Das Modellergebnis wird gegen ein Schema geprüft, bevor die Anwendung damit arbeitet. Für Teams, die Pydantic ohnehin nutzen, ist das keine neue Denkweise. Typisierung verhindert Formfehler – nicht inhaltlich falsche Antworten.
Microsoft Agent Framework
Die Zusammenführung von AutoGen und Semantic Kernel für .NET und Python. Für neue Vorhaben ist das der Weg: AutoGen wird laut Microsoft nur noch gewartet. Bequem für Microsoft-Landschaften, und genau deshalb eine bewusste Entscheidung über Bindung.
→ Microsoft Agent Framework im Glossar
3) Infrastruktur und Ausführung
Drei verschiedene Fragen: Wo rechnet es? Wo darf fremder Code laufen? Wie übersteht ein Lauf einen Fehler?
Modal
Python-Funktionen in der Cloud, auch auf GPUs, ohne Infrastrukturarbeit. Für Stoßlasten gemacht: 200.000 Abschnitte neu vektorisieren, einen Bildkatalog neu beschriften, ein Video-Batch rendern. Zwischen den Läufen läuft nichts. Achtung: Ein falsch geschriebener Parallellauf verbrennt in Minuten ein Monatsbudget.
Daytona
Kurzlebige, isolierte Umgebungen für KI-generierten Code. Sobald ein Agent Code ausführt, darf die Antwort auf „wo läuft das?" nicht „auf dem Anwendungsserver" sein. Wichtig für die Auswahl: Das öffentliche Repository ist seit Juni 2026 eingefroren – für neue Vorhaben ist E2B derzeit die naheliegendere Wahl.
Trigger.dev
Langlaufende Hintergrundaufgaben in TypeScript, ohne Zeitgrenzen serverloser Funktionen: wiederaufnehmbar, versioniert, nachvollziehbar. Jede ernsthafte KI-Funktion im Marketing ist ein Hintergrundprozess – 240 Motivvarianten in vier Sprachen sind kein HTTP-Request. Quelloffen und selbst betreibbar.
4) Web-Daten und Werkzeugzugriff
Ohne Zugriff auf die Welt bleibt ein Agent ein Textgenerator.
Apify
Marktplatz fertiger Scraper (Actors), aufrufbar per API oder über MCP. Wiederkehrende Wettbewerbs- und Preisbeobachtung kauft man hier ein, statt die Pflege brechender Selektoren selbst zu tragen. Die rechtliche Prüfung, ob eine Quelle erhoben werden darf, nimmt kein Werkzeug ab.
Scrapfly
Scraping-API, die den unangenehmen Teil übernimmt: Blockaden, Proxys, echtes Rendering. Der Aufwand beim Web-Zugriff liegt nicht im Auslesen, sondern im Hineinkommen. Technisch möglich ist dabei nicht gleich zulässig – robots.txt ist eine Vorgabe, kein Hindernis.
Composio
Werkzeugschicht, die Agenten Zugriff auf hunderte Geschäftsanwendungen gibt, inklusive Anmeldung je Endnutzer. Das ist der Unterschied zwischen einem Agenten, der Text vorschlägt, und einem, der Aufgaben abschließt. Und genau deshalb: schreibende Aktionen hinter Genehmigungsschritte, Rechte auf das Minimum.
5) Qualität und Beobachtbarkeit
Der Teil, der aus einem Experiment ein Produkt mit Abnahmekriterium macht.
Braintrust
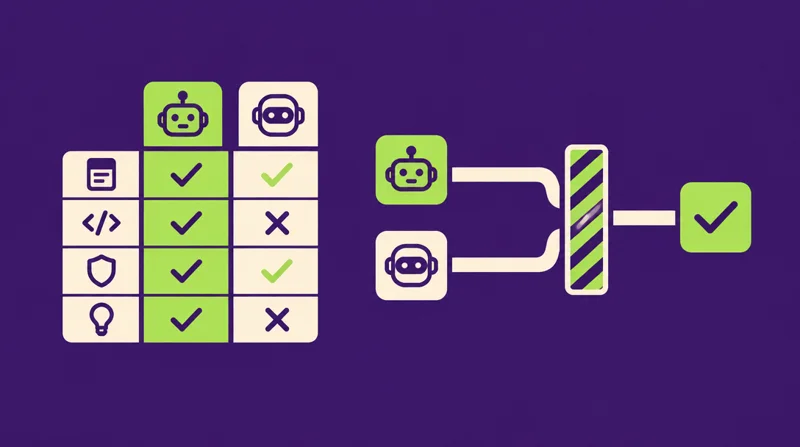
Evaluationsplattform: Testdatensätze, Bewertungsfunktionen, Versionsvergleich, Qualitätsschranke in der Auslieferung. Ohne das ist jede Prompt-Änderung Bauchgefühl. 50 bis 200 echte Anfragen mit klarem Sollergebnis sagen mehr als tausend erfundene.
Helicone
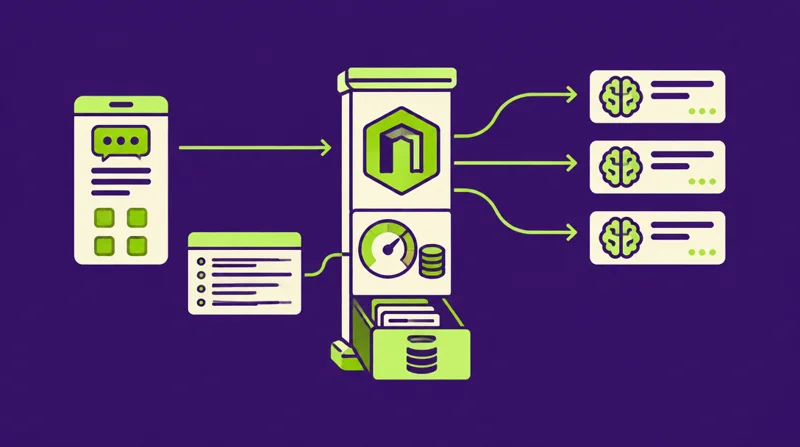
Quelloffene Beobachtbarkeit für Modellaufrufe: Kosten, Latenz, Fehler, Nutzung je Anwendung, dazu Zwischenspeicherung. Die typische Erkenntnis nach vier Wochen ist banal und teuer: Ein großer Kostenanteil entfällt auf eine Funktion, die drei Personen nutzen. Selbst betreibbar – relevant, wenn Prompts das eigene Netz nicht verlassen sollen.
Arize Phoenix
Quelloffenes Tracing und Evaluation auf OpenTelemetry-Konventionen. Der größte Hebel liegt in der Abruf-Diagnose: Wenn die richtige Passage auf Rang 12 liegt und nie in den Kontext kommt, hilft kein besserer Prompt, sondern Reranking. Lokal und selbst betreibbar.
6) Identität, Sprache und Zahlung
Hier entscheidet sich, in wessen Namen ein Agent handelt – und wie weit er gehen darf.
Clerk
Anmeldung, Sitzungen, Organisationen und Rollen als Dienst. Für agentische Systeme ist der Kern nicht das Anmeldefenster, sondern die Identitätsfrage: Handelt der Agent mit den Rechten des angemeldeten Nutzers, ist der Schaden begrenzt. Handelt er mit einem Dienstschlüssel, sind alle Zugriffsregeln umgangen.
ElevenLabs
Sprachsynthese in vielen Sprachen und Stimmen, dazu Bausteine für Sprach-Agenten. Für mehrsprachige Kampagnen ist das der Unterschied zwischen einem Spot und zwölf. Zwei harte Bedingungen: Stimmen realer Personen nur mit dokumentierter Einwilligung, und KI-Interaktion muss erkennbar sein.
Vapi
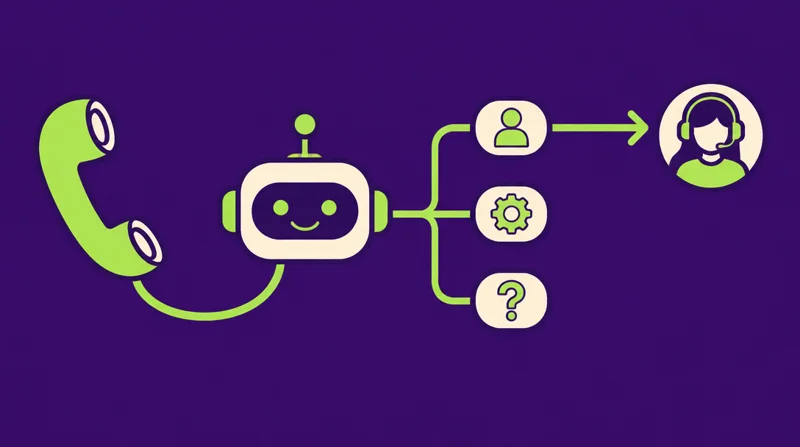
Sprach-Agenten am Telefon: annehmen, zuhören, antworten, Werkzeuge aufrufen, weiterleiten. Es funktioniert bei eng geschnittenen Aufgaben – Termin, Rückruf, Status. Sobald es um Zusagen, Preise oder Verträge geht, ist Weiterleitung an einen Menschen die richtige Antwort und kein Scheitern.
Stripe Agentic Commerce
Bausteine dafür, dass Agenten Käufe anbahnen und abschließen – MCP-Server, Ansätze für agentische Zahlungen. Teile davon sind ausdrücklich Vorschau. Unsere Empfehlung ist entsprechend zweigeteilt: Produktdaten jetzt maschinenlesbar aufstellen, Zahlungsflüsse nicht auf Vorschaufunktionen bauen.
→ Stripe Agentic Commerce im Glossar
Wie man daraus auswählt
Vier Fragen, in dieser Reihenfolge, ersparen die meisten Fehlentscheidungen.
Wo liegen die Daten, und wer verarbeitet sie? Bei personenbezogenen Inhalten ist das keine Detailfrage. Belegbar selbst betreibbar sind in dieser Liste Weaviate, Helicone, Arize Phoenix und Trigger.dev. Alles andere braucht eine Auftragsverarbeitungsvereinbarung mit Blick auf Region und Protokollierung.
Was kostet der Betrieb, nicht die Lizenz? Zwei zusätzliche Dienste bedeuten zwei weitere Systeme mit Backups, Upgrades und Bereitschaft. Eine Vektordatenbank neben der vorhandenen Postgres-Instanz braucht einen Grund, der über „steht in jedem Tutorial" hinausgeht.
Ist das Projekt lebendig? Der eingefrorene Daytona-Stand und AutoGen im Wartungsmodus sind die zwei Beispiele in dieser Liste. Beides ist kein Urteil über Qualität, aber ein Grund, eine Alternative mitzubewerten, bevor ein Ablauf davon abhängt.
Wird Qualität gemessen? Ohne Testsatz und Bewertung ist jede Verbesserung Behauptung. Das ist die einzige Kategorie in dieser Liste, bei der wir raten, sie nicht später nachzuziehen: Evaluation und Beobachtbarkeit gehören in den ersten Sprint, nicht in den fünften.
Was wir selbst einsetzen
Wir arbeiten produktiv mit Postgres samt Row Level Security als Datenbasis, mit Vorschau-Auslieferung je Änderung, mit dauerhaft ausgeführten Hintergrundaufgaben für alles, was länger als eine Anfrage dauert, und mit Tracing samt festen Testsätzen für jede kundenwirksame KI-Funktion. Sprach- und Telefonie-Agenten setzen wir nur mit erkennbarer KI-Kennzeichnung und klarer Weiterleitung an Menschen um.
Was wir nicht tun: Werkzeuge einführen, weil sie in einer Liste stehen. Jedes zusätzliche System muss eine Aufgabe übernehmen, die vorher jemand von Hand gemacht hat – sonst verschiebt es Arbeit statt sie zu ersparen.
Wenn Sie eine dieser Schichten gerade bewerten, sprechen wir über Ihren konkreten Fall statt über Werkzeuglisten. Und wenn Sie Teil eins noch nicht gelesen haben: dort stehen die zwanzig Werkzeuge der Grundschicht.
Häufige Fragen
Worum geht es bei „Der agentische Stack 2026, Teil 2: 20 weitere Werkzeuge für Gedächtnis, Qualität und Ausführung“?
Pinecone, Weaviate, Zep, LiteLLM, Braintrust, Composio und 14 weitere: die Schichten, die man erst braucht, wenn ein Prototyp in Betrieb geht — mit Grenzen, Quellen und vier Auswahlfragen.
Inhalt: Was ist wichtig?
Daten und Gedächtnis: Pinecone, Weaviate, Zep, LlamaIndex Modellzugang und Agenten-Frameworks: LiteLLM, Pydantic AI, Microsoft Agent Framework Infrastruktur und Ausführung: Modal, Daytona, Trigger.
Daten und Gedächtnis: Was ist wichtig?
Ein Agent ist nur so gut wie das, was er findet – und was er vom letzten Gespräch behalten hat.
Pinecone: Was ist wichtig?
<img src="/blog/tools/pinecone.webp" alt="Flache Illustration einer verwalteten Vektordatenbank mit Indexkarten und Ähnlichkeitssuche" loading="lazy" width="800" height="450" / Verwaltete Vektordatenbank für semantische Suche und RAG.
Weitere Artikel
Diese Beiträge könnten Sie auch interessieren
 Tools & Technologie
Der agentische Stack 2026: 20 Werkzeuge, die agentische Entwicklung tragen
Supabase, Vercel, Inngest, Langfuse, Attio und 15 weitere: die fünf Schichten eines agentischen Stacks, was jedes Werkzeug leistet, wo die Grenzen liegen — und vier Kriterien für die eigene Auswahl.
 Tools & Technologie
Legacy-Refactoring & Code-Übersetzung: was Agenten wirklich leisten
Python zu Rust in Tagen statt Monaten: wie agentische Portierung praktisch abläuft, warum Faktoren von 10 bis 40 nicht übertragbar sind und welche Tests, Benchmarks und Zuständigkeiten vorher stehen müssen.
 Tools & Technologie
Grok Bot: xAIs KI-Teammates mit eigenem Rechner
Seit 11. August 2026 in der Beta: Bots mit eigenem Cloud-Rechner loggen sich in eure Tools ein und arbeiten Aufgaben zu Ende. Was das für Marketing, Rechte und Grokipedia bedeutet.