Legacy-Refactoring & Code-Übersetzung: was Agenten wirklich leisten
Kurz erklärt
Python zu Rust in Tagen statt Monaten: wie agentische Portierung praktisch abläuft, warum Faktoren von 10 bis 40 nicht übertragbar sind und welche Tests, Benchmarks und Zuständigkeiten vorher stehen müssen.
Inhaltsverzeichnis
Alte Bibliotheken auszutauschen war lange eine Entscheidung gegen Sprachwechsel: Wer Python-Logik in Rust neu schreiben wollte, brauchte Monate Einarbeitung, Spezialwissen und ein belastbares Testnetz. Meist blieb es beim Vorsatz.
Agenten verändern die Rechnung – nicht, weil sie perfekten Code schreiben, sondern weil sie Syntax, Idiome, Build-Systeme und Compiler-Feedback beherrschen und daraus iterieren. Der Aufwand verschiebt sich von der Erstellung zur Bewertung. Genau dort entscheidet sich, ob ein Refactoring ein Gewinn oder ein Risiko ist.
1) Was agentische Portierung praktisch bedeutet
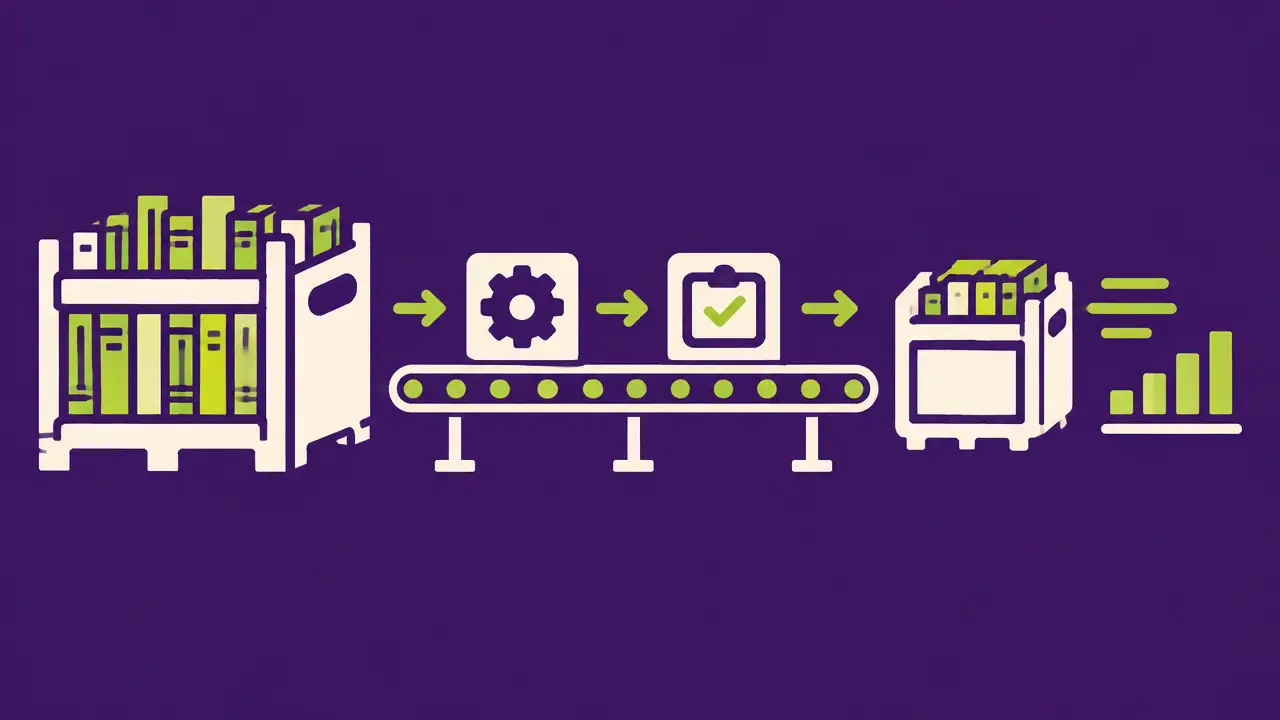
Der Ablauf ist in der Praxis erstaunlich gleichförmig:
- Verhalten festschreiben. Bevor irgendetwas übersetzt wird, entsteht eine Testsuite gegen die bestehende Implementierung, gespeist mit echten Eingabedaten.
- Schnitt festlegen. Portiert wird der rechenintensive Kern, nicht die gesamte Anwendung. Die Schnittstelle nach außen bleibt stabil.
- Übersetzen und iterieren. Der Agent erzeugt die Zielimplementierung und arbeitet sich durch Compiler- und Testfehler.
- Benchmark gegen das Original. Gleiche Eingaben, realistische Last, dokumentierte Zahlen.
- Review durch jemanden mit Spracherfahrung. Speicherverhalten, Nebenläufigkeit, Fehlerbehandlung.
Dieses Muster beschreibt das Glossar als Polyglot Agentic Programming: Code in einer Sprache erzeugen, die man selbst nicht routiniert beherrscht – mit verschobener, nicht verschwundener Verantwortung.
2) Die Sache mit den Performance-Zahlen
Im Umfeld solcher Projekte kursieren Faktoren von zehn bis vierzig. Solche Angaben sind plausibel, aber nicht übertragbar: Sie stammen aus Fällen, in denen eine interpretierte Sprache mit hohem Aufrufaufwand durch kompilierten Code mit besserer Speicherlokalität ersetzt wurde. Wo bereits vektorisierte Bibliotheken im Einsatz sind, fällt der Gewinn deutlich kleiner aus – manchmal auf wenige Prozent.
Belastbar ist deshalb nur eine Zahl: der eigene Benchmark, gemessen auf eigenen Daten, unter eigener Last, vor und nach der Umstellung. Alles andere ist Werbung – auch wenn es technisch nachvollziehbar klingt.
Wo sich der Aufwand typischerweise rechnet:
- Verarbeitung großer Asset- oder Datenmengen in Stapeln
- Bild- und Videoaufbereitung in Produktionspipelines
- rechenintensive Vorverarbeitung vor Modellaufrufen
- Dienste mit dauerhaft hoher Anfragelast, wo Rechenzeit direkt Infrastrukturkosten ist
3) Kosteneffekte jenseits der Laufzeit
Der Performance-Gewinn ist nur ein Teil. Zwei weitere Effekte sind in der Praxis oft größer:
- Infrastruktur. Wenn ein Stapellauf statt vier Stunden zwanzig Minuten braucht, sinken Rechenkosten und die Notwendigkeit, Kapazität für Spitzen vorzuhalten.
- Prozess. Ein Lauf, der in Minuten durchläuft, kann mehrmals täglich stattfinden. Damit ändert sich nicht die Technik, sondern das Arbeiten – Korrekturen werden möglich, wo vorher eine Nacht dazwischenlag.
Dagegen steht eine Position, die selten kalkuliert wird: Wartung in einer Sprache, die im Team niemand liest. Das ist kein Nebenaspekt, sondern der entscheidende Kostenposten über die Laufzeit.
4) Die Risiken, die wirklich zählen
- Funktionale Gleichheit ohne Lastgleichheit. Tests grün, Verhalten unter Nebenläufigkeit oder an Speichergrenzen abweichend. Ohne Lasttests bleibt das unentdeckt.
- Abnahme ohne Sprachkompetenz. Wer den Zielcode nicht lesen kann, kann Sicherheitsfragen nicht beurteilen. Ein Review durch erfahrene Personen ist keine Formalität.
- Wartungsschuld. Abhängigkeiten aktualisieren, Sicherheitslücken schließen, Fehler diagnostizieren – alles in einer Sprache ohne interne Zuständigkeit.
- Teil-Portierung ohne klare Grenze. Zwei Implementierungen derselben Logik in zwei Sprachen sind der schlechteste aller Zustände.
Die Gegenmaßnahme ist unspektakulär: Bevor portiert wird, steht fest, wer den Zielcode dauerhaft betreut – namentlich.
5) Ein begrenztes Vorgehen in vier Wochen
- Woche 1: Kandidaten auswählen. Kriterium: klar abgegrenzt, messbar rechenintensiv, stabile Schnittstelle, Zuständigkeit geklärt. Basiswerte messen.
- Woche 2: Testsuite gegen das Original auf echten Daten aufbauen, inklusive Randfälle und Fehlerpfade.
- Woche 3: Portierung durch Agenten, Iteration über Tests und Benchmarks.
- Woche 4: Review durch erfahrene Person, Lasttest, Entscheidung mit dokumentierten Zahlen: ablösen, parallel betreiben oder verwerfen.
Ein verworfener Versuch ist kein Fehlschlag, wenn die Testsuite bleibt – sie ist beim nächsten Umbau der wertvollste Teil.
Fazit
Agentische Code-Übersetzung macht Legacy-Refactoring von einer Kapazitätsfrage zu einer Bewertungsfrage. Der Gewinn ist real, aber nicht pauschal: Er hängt am Ausgangszustand, und er ist nur mit eigenem Benchmark belegbar. Wer Verhalten vorher festschreibt, Lasttests fährt und Zuständigkeit klärt, holt Performance und Kosten heraus, ohne ein unlesbares Bauteil zu erben.
Weiterführend: Warum Architektur-Leitplanken bei agentischer Entwicklung wichtiger werden, steht in Vibe Coding vs. Software-Architektur.
Häufige Fragen
Worum geht es bei „Legacy-Refactoring & Code-Übersetzung: was Agenten wirklich leisten“?
Python zu Rust in Tagen statt Monaten: wie agentische Portierung praktisch abläuft, warum Faktoren von 10 bis 40 nicht übertragbar sind und welche Tests, Benchmarks und Zuständigkeiten vorher stehen müssen.
Was agentische Portierung praktisch bedeutet: Was ist wichtig?
Der Ablauf ist in der Praxis erstaunlich gleichförmig: Verhalten festschreiben. Bevor irgendetwas übersetzt wird, entsteht eine Testsuite gegen die bestehende Implementierung, gespeist mit echten Eingabedaten.
Die Sache mit den Performance-Zahlen: Was ist wichtig?
Im Umfeld solcher Projekte kursieren Faktoren von zehn bis vierzig. Solche Angaben sind plausibel, aber nicht übertragbar: Sie stammen aus Fällen, in denen eine interpretierte Sprache mit hohem Aufrufaufwand durch kompilierten Code mit besserer Speicherlokalität ersetzt wurde.
Kosteneffekte jenseits der Laufzeit: Was ist wichtig?
Der Performance-Gewinn ist nur ein Teil. Zwei weitere Effekte sind in der Praxis oft größer: Infrastruktur. Wenn ein Stapellauf statt vier Stunden zwanzig Minuten braucht, sinken Rechenkosten und die Notwendigkeit, Kapazität für Spitzen vorzuhalten.
Weitere Artikel
Diese Beiträge könnten Sie auch interessieren
 Tools & Technologie
Der agentische Stack 2026: 20 Werkzeuge, die agentische Entwicklung tragen
Supabase, Vercel, Inngest, Langfuse, Attio und 15 weitere: die fünf Schichten eines agentischen Stacks, was jedes Werkzeug leistet, wo die Grenzen liegen — und vier Kriterien für die eigene Auswahl.
 Tools & Technologie
Der agentische Stack 2026, Teil 2: 20 weitere Werkzeuge für Gedächtnis, Qualität und Ausführung
Pinecone, Weaviate, Zep, LiteLLM, Braintrust, Composio und 14 weitere: die Schichten, die man erst braucht, wenn ein Prototyp in Betrieb geht — mit Grenzen, Quellen und vier Auswahlfragen.
 Tools & Technologie
Grok Bot: xAIs KI-Teammates mit eigenem Rechner
Seit 11. August 2026 in der Beta: Bots mit eigenem Cloud-Rechner loggen sich in eure Tools ein und arbeiten Aufgaben zu Ende. Was das für Marketing, Rechte und Grokipedia bedeutet.